Apache Flink でストリーム処理を行う
Step 1: Compute Pool を作成する
Confluent Cloud for Apache Flink では、Compute Pool(コンピュートプール)を作成して処理を実行します。
- Confluent Cloud Console で対象の環境を開きます
- Flink を選択し、Compute pools タブを開きます
- Add compute pool を選択します
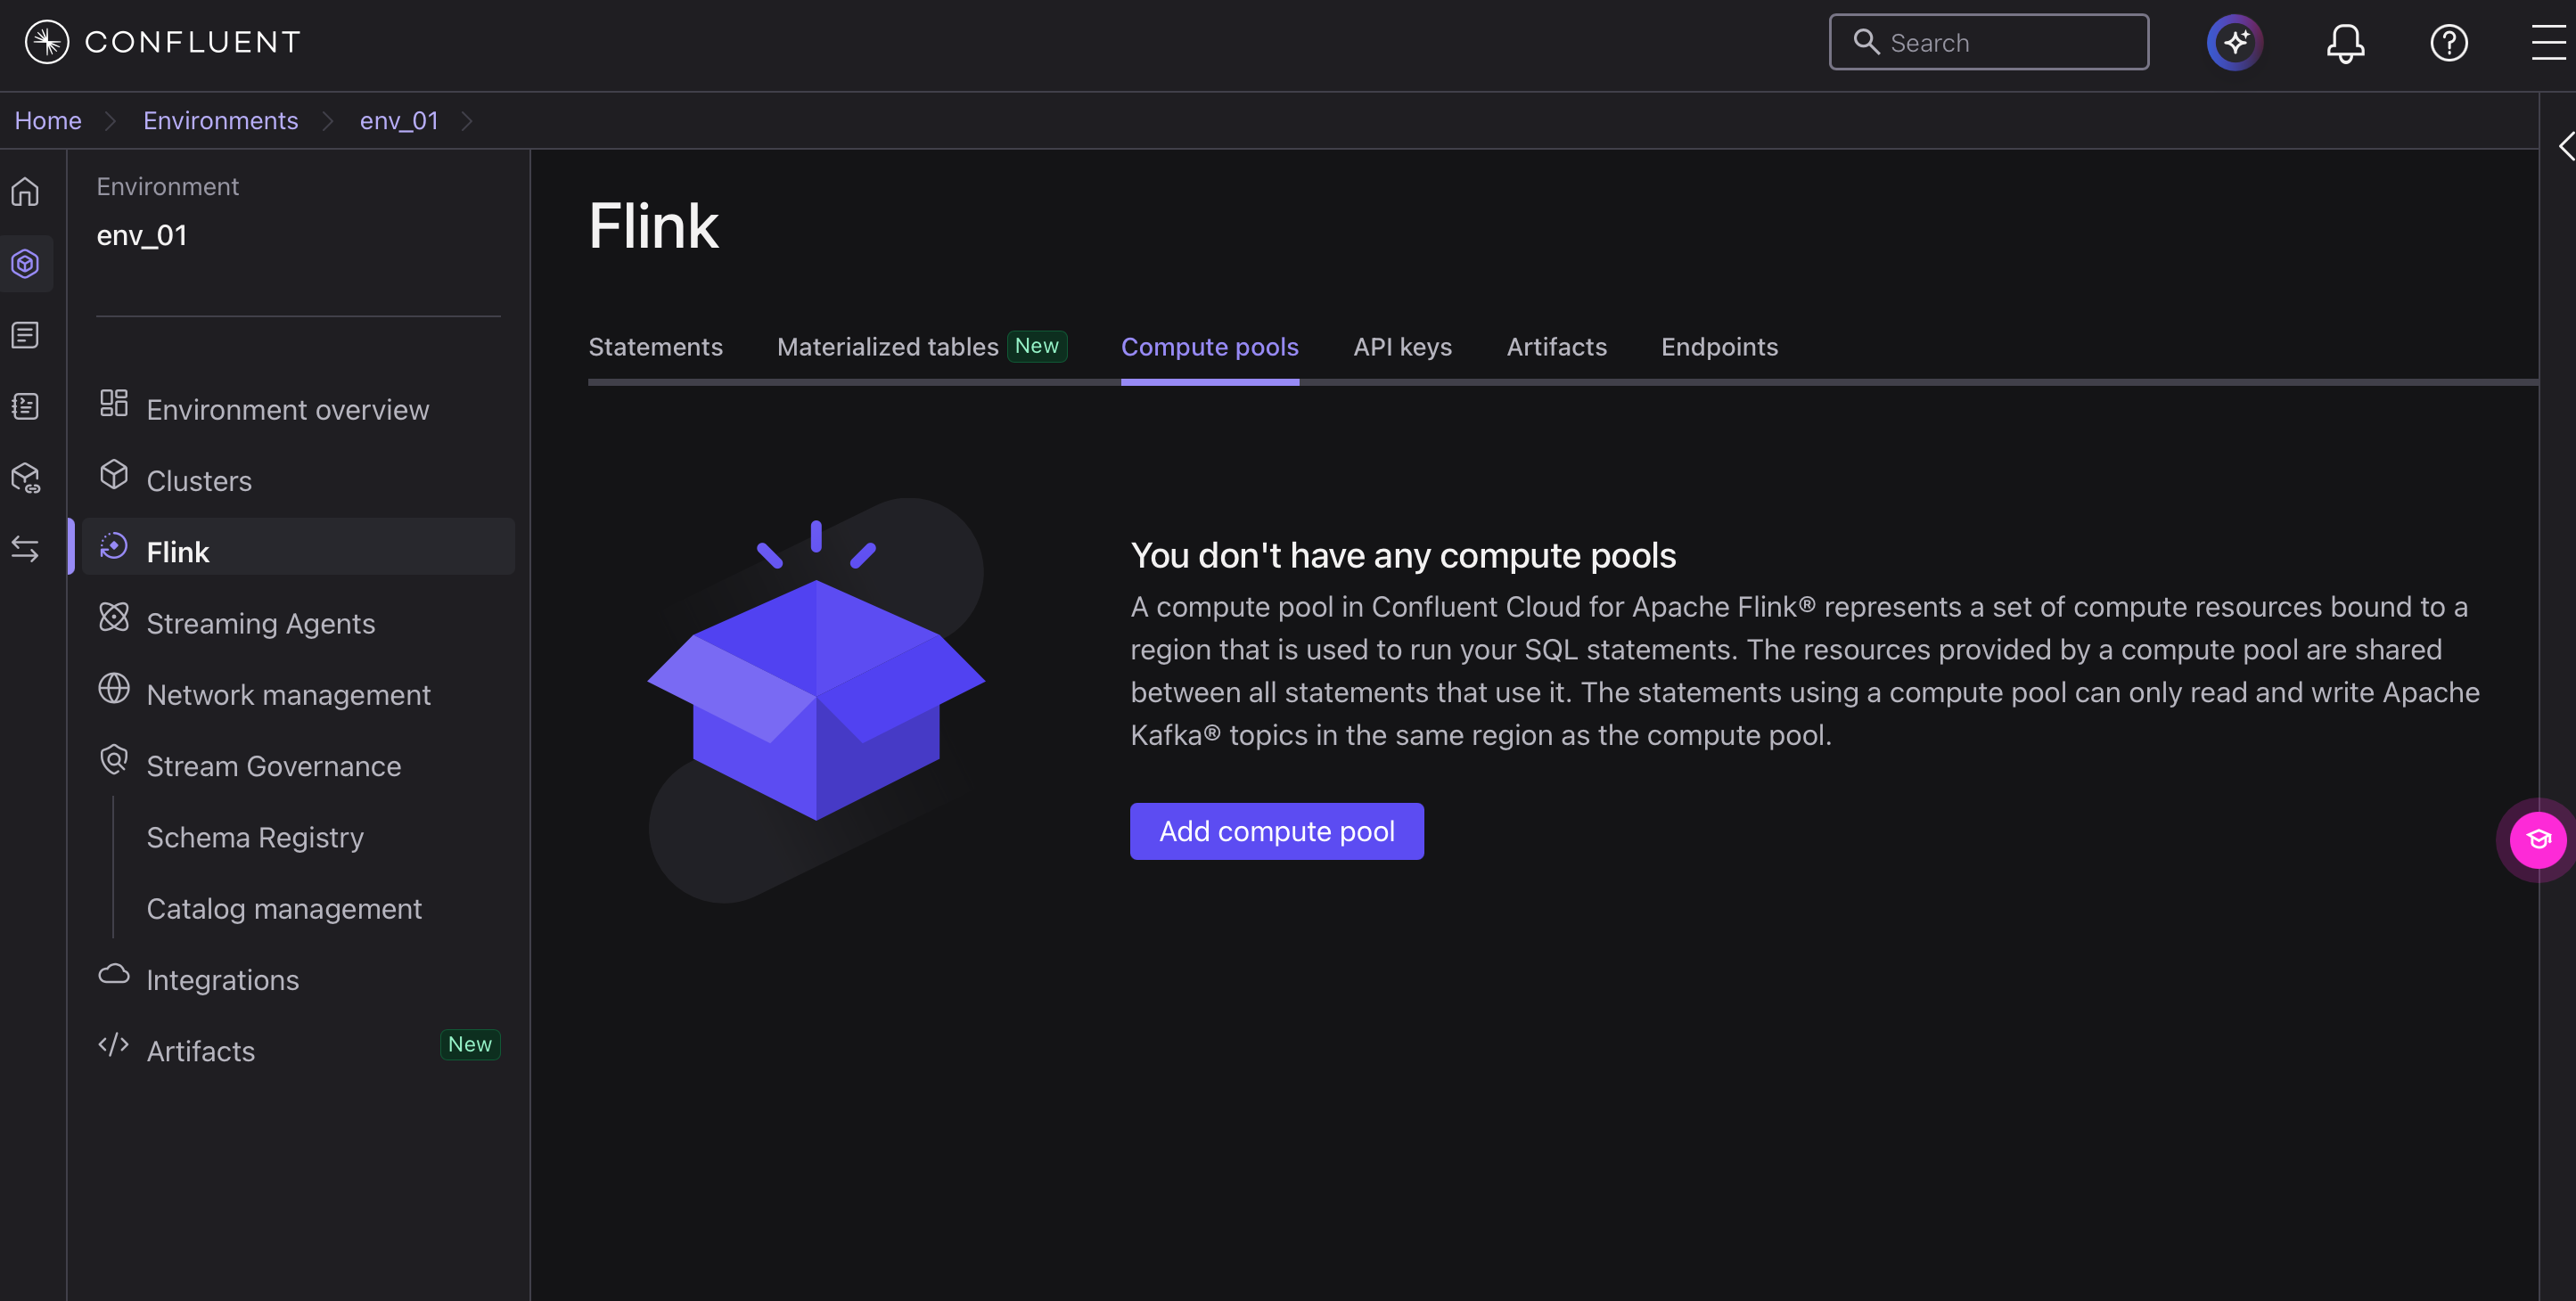
- 「Create compute pool」ウィザード(1. Select region → 2. Review and create)で、クラウドプロバイダーとリージョンを選択します
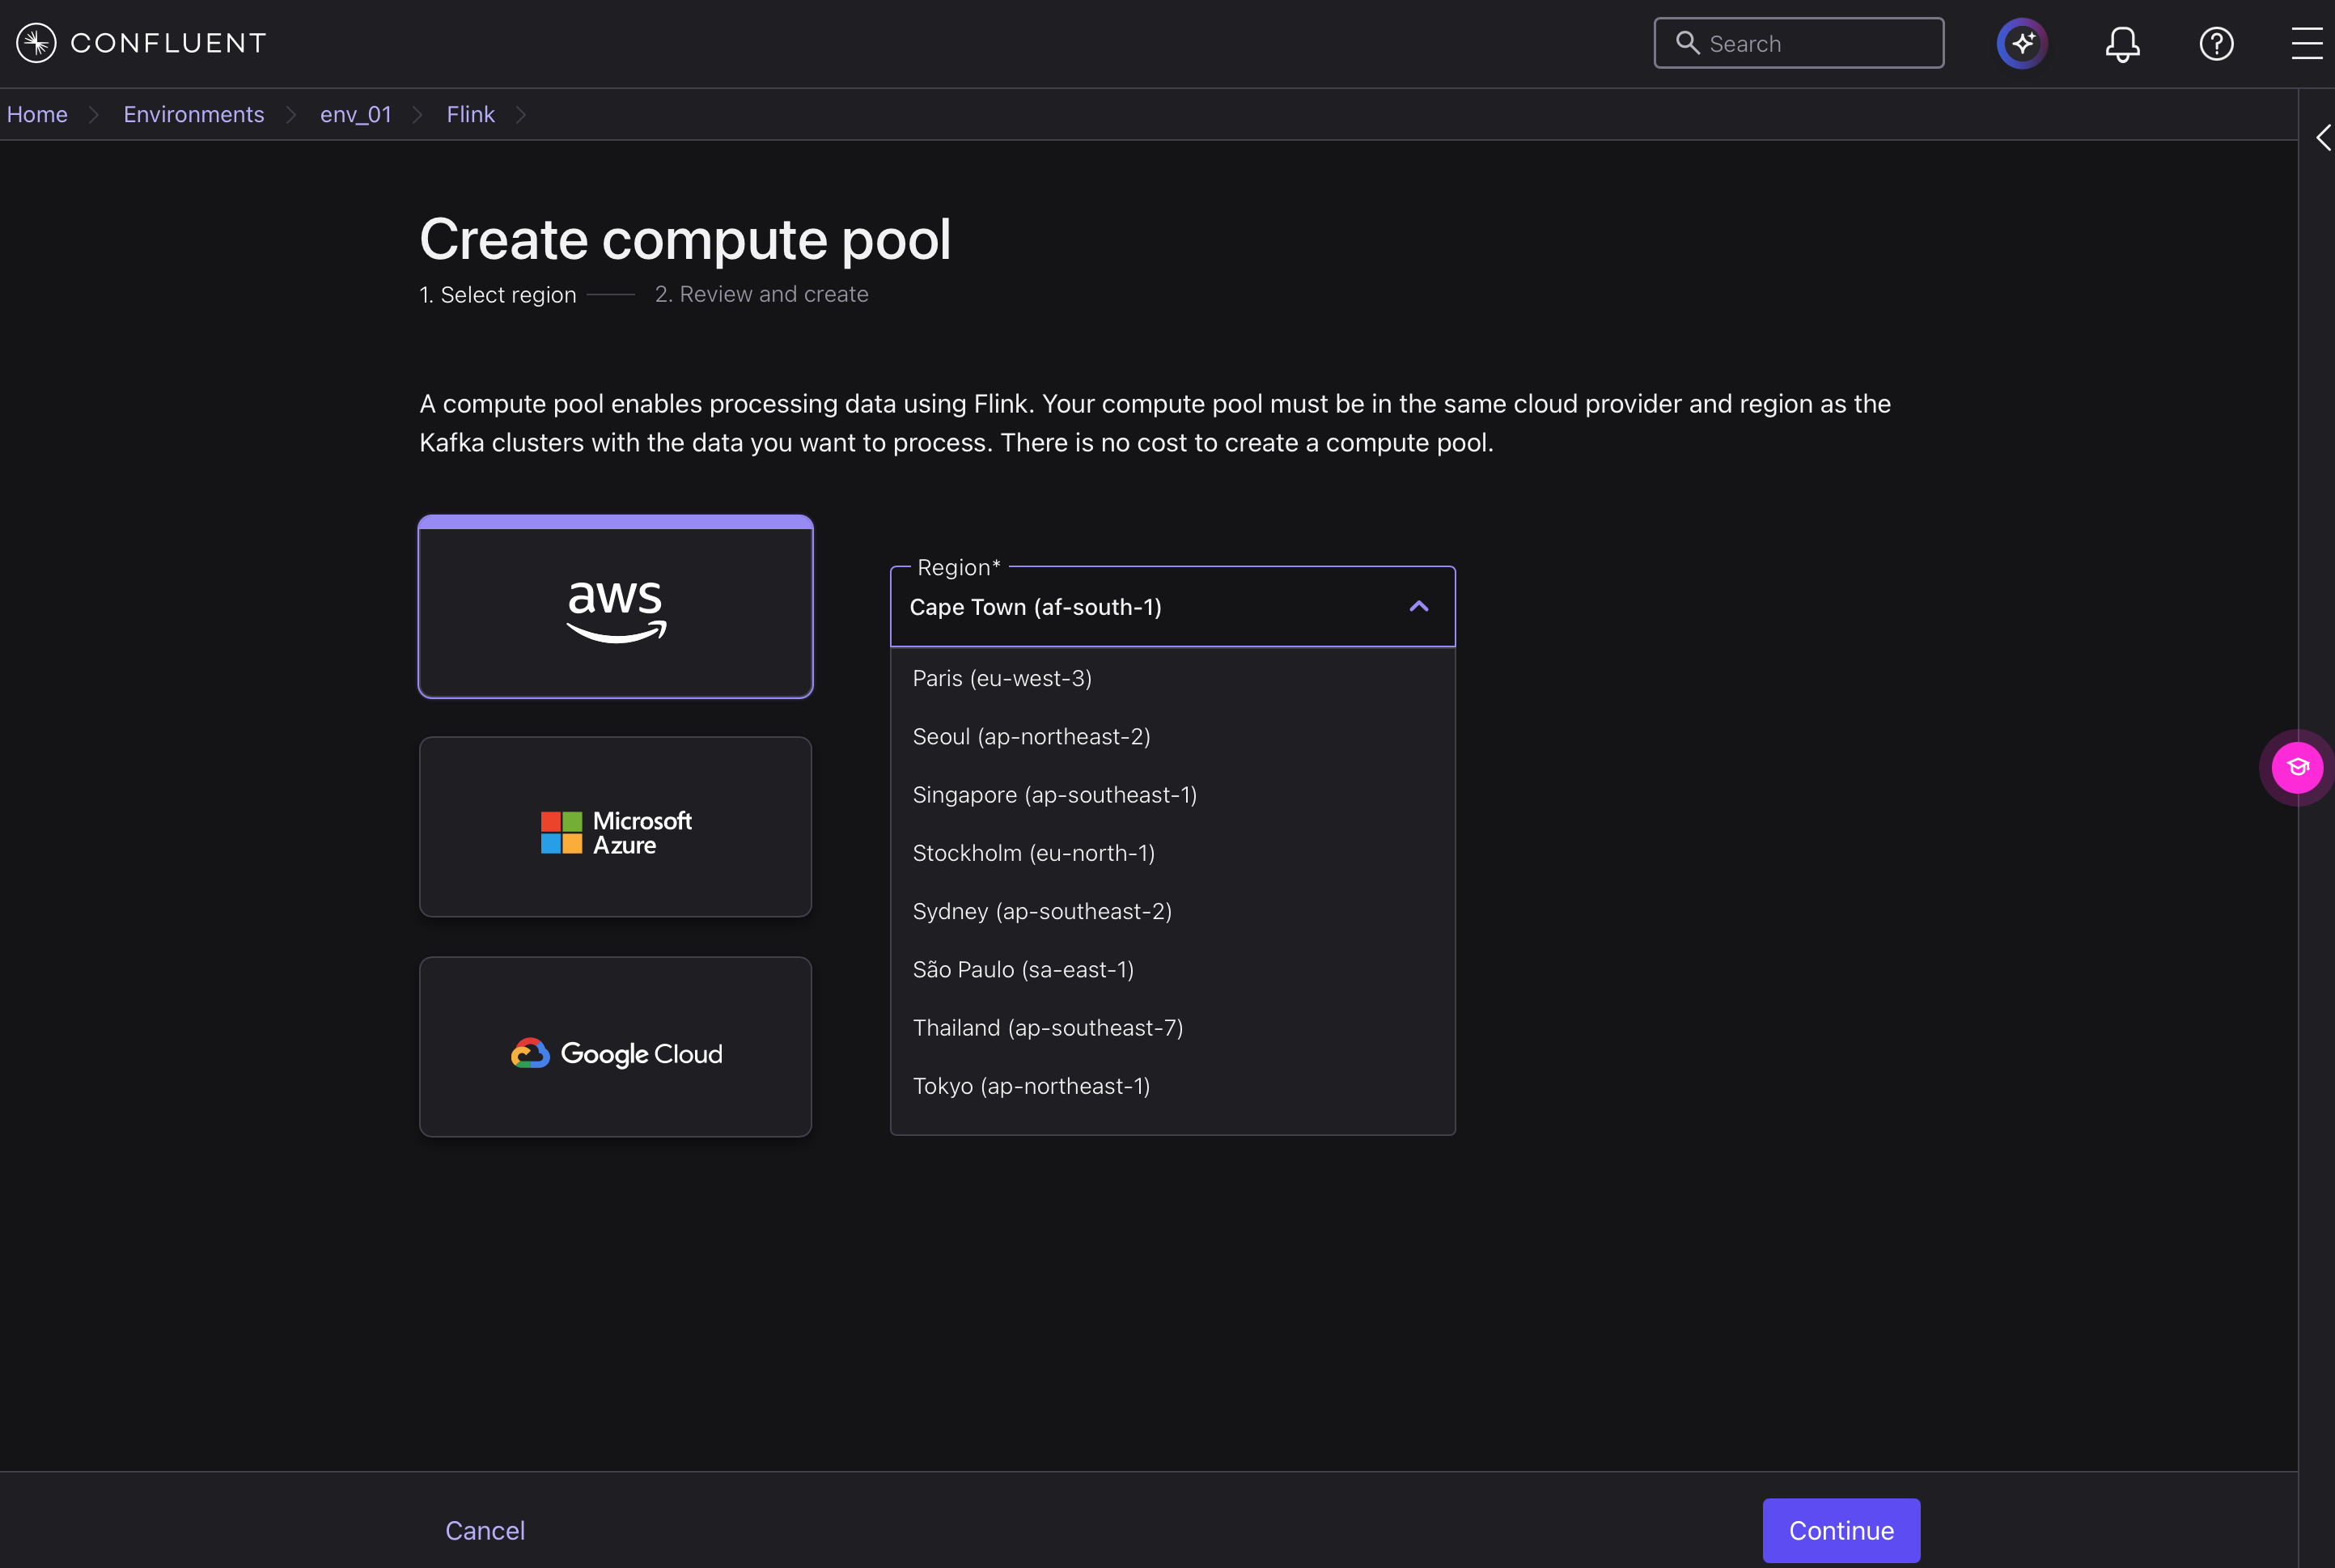
この画面では、Flink が利用できるクラウドプロバイダーとリージョンを確認できます。Flink の対応リージョンは Kafka クラスターとは別に定義されているため、リージョンを選択する と併せてご確認ください。
【重要】Compute Pool は対象データと同一クラウド・同一リージョンに作成します
作成画面に明記されているとおり、Compute Pool は、処理対象のデータを持つ Kafka クラスターと同一のクラウドプロバイダー・同一のリージョンに作成する必要があります。Compute Pool を使うステートメントが読み書きできるのは、同一リージョンの Topic のみです。リージョン設計の段階で、Kafka クラスターと Flink の配置を揃えて計画してください。
なお、Compute Pool の作成自体に費用は発生しません(作成画面に明記)。課金はステートメントの実行時に CFU 単位で発生します。
Compute Pool の容量上限は 1,000 CFU/プールまで拡張されています(Limited Availability プログラム)。
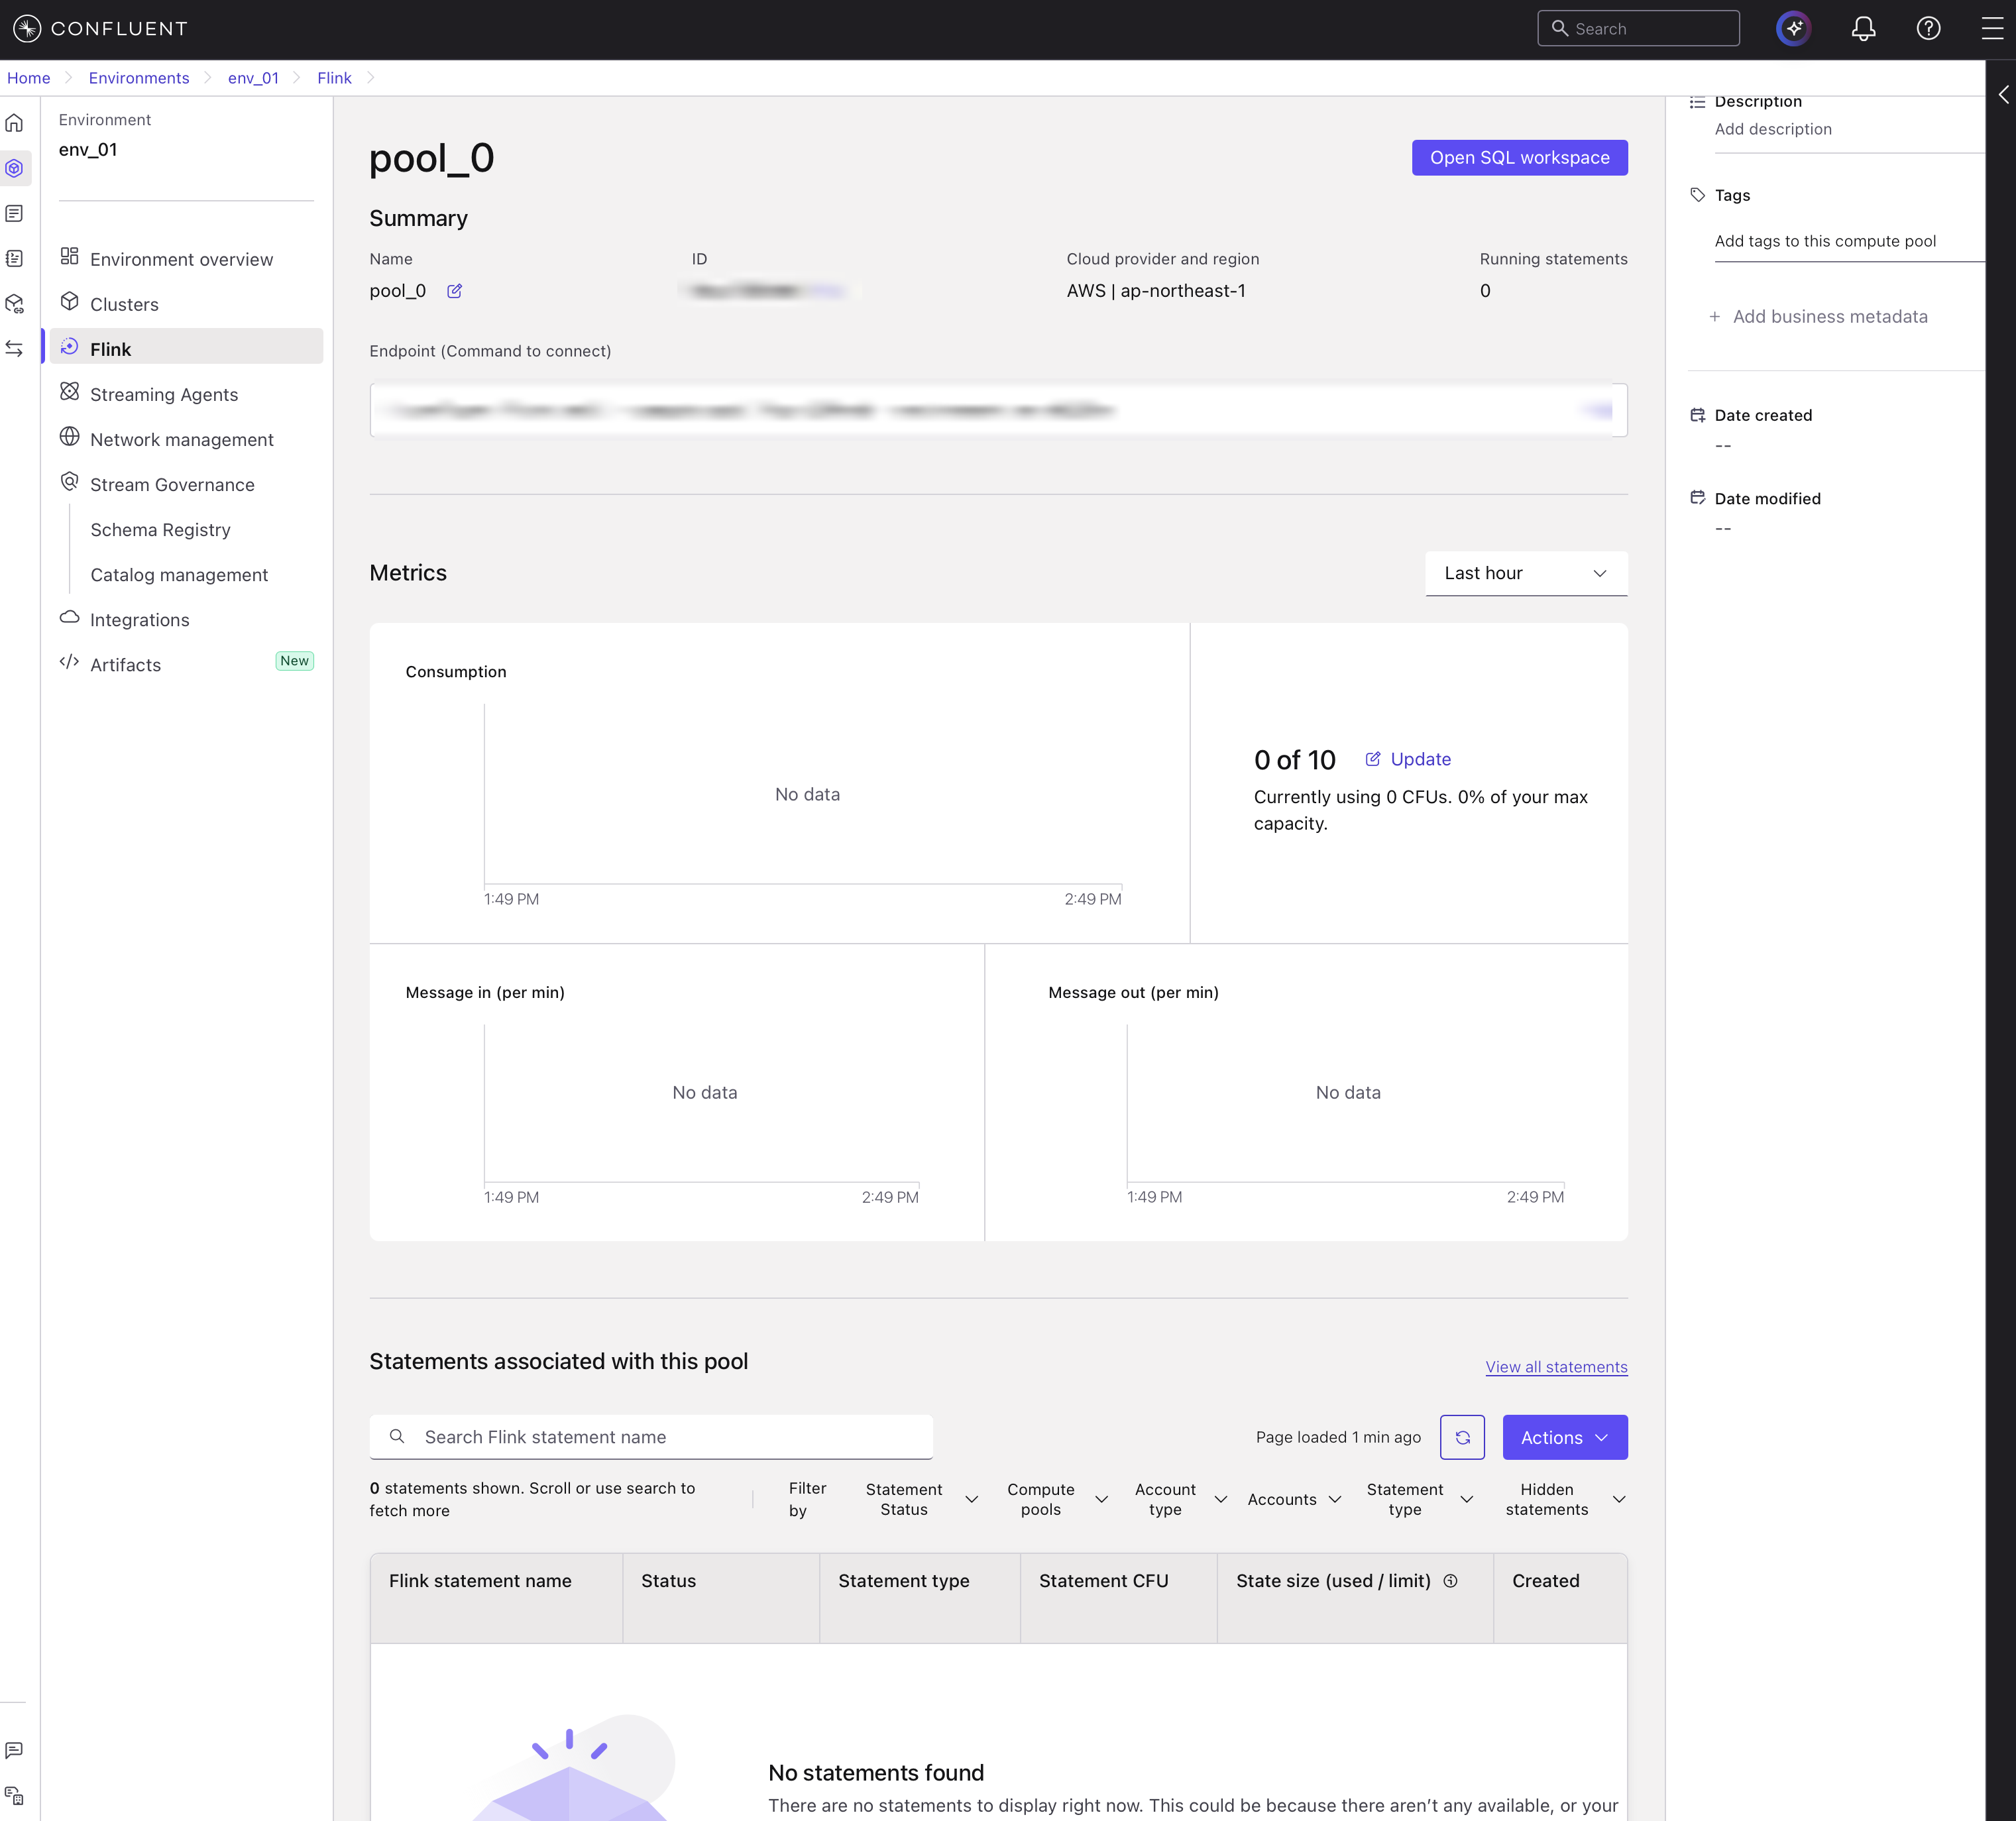
作成が完了すると、プールの詳細ページが表示されます。ここから Open SQL workspace で SQL ワークスペースを開けるほか、Confluent CLI で SQL シェルに接続するためのコマンド(confluent flink shell)、CFU の消費状況(最大 CFU に対する現在の使用量)、プールに紐づくステートメントの一覧を確認できます。最大 CFU はこの画面の Update からあとから変更できます。
Step 2: アクセス権限を設定する
Flink の利用には、Flink 用の API キーの発行と FlinkDeveloper ロールの付与が必要です。
FlinkDeveloper ロールは、環境全体ではなく個々の Compute Pool にスコープを絞って付与できます(プールレベル RBAC)。これにより、ユーザーやサービスが担当するワークスペースとステートメントにのみアクセスできる構成となり、最小権限の原則を適用しやすくなります。
参考:Grant Role-Based Access to Flink(英語)
Step 3: Flink SQL で処理を実行する
処理の実行方法は次のとおりです。
| 方法 | 概要 |
|---|---|
| Confluent Cloud Console | ブラウザ上のワークスペースで Flink SQL を実行します |
| Confluent CLI(SQL シェル) | コマンドラインから対話的に実行します |
| Java / Python Table API | プログラムから実行します |
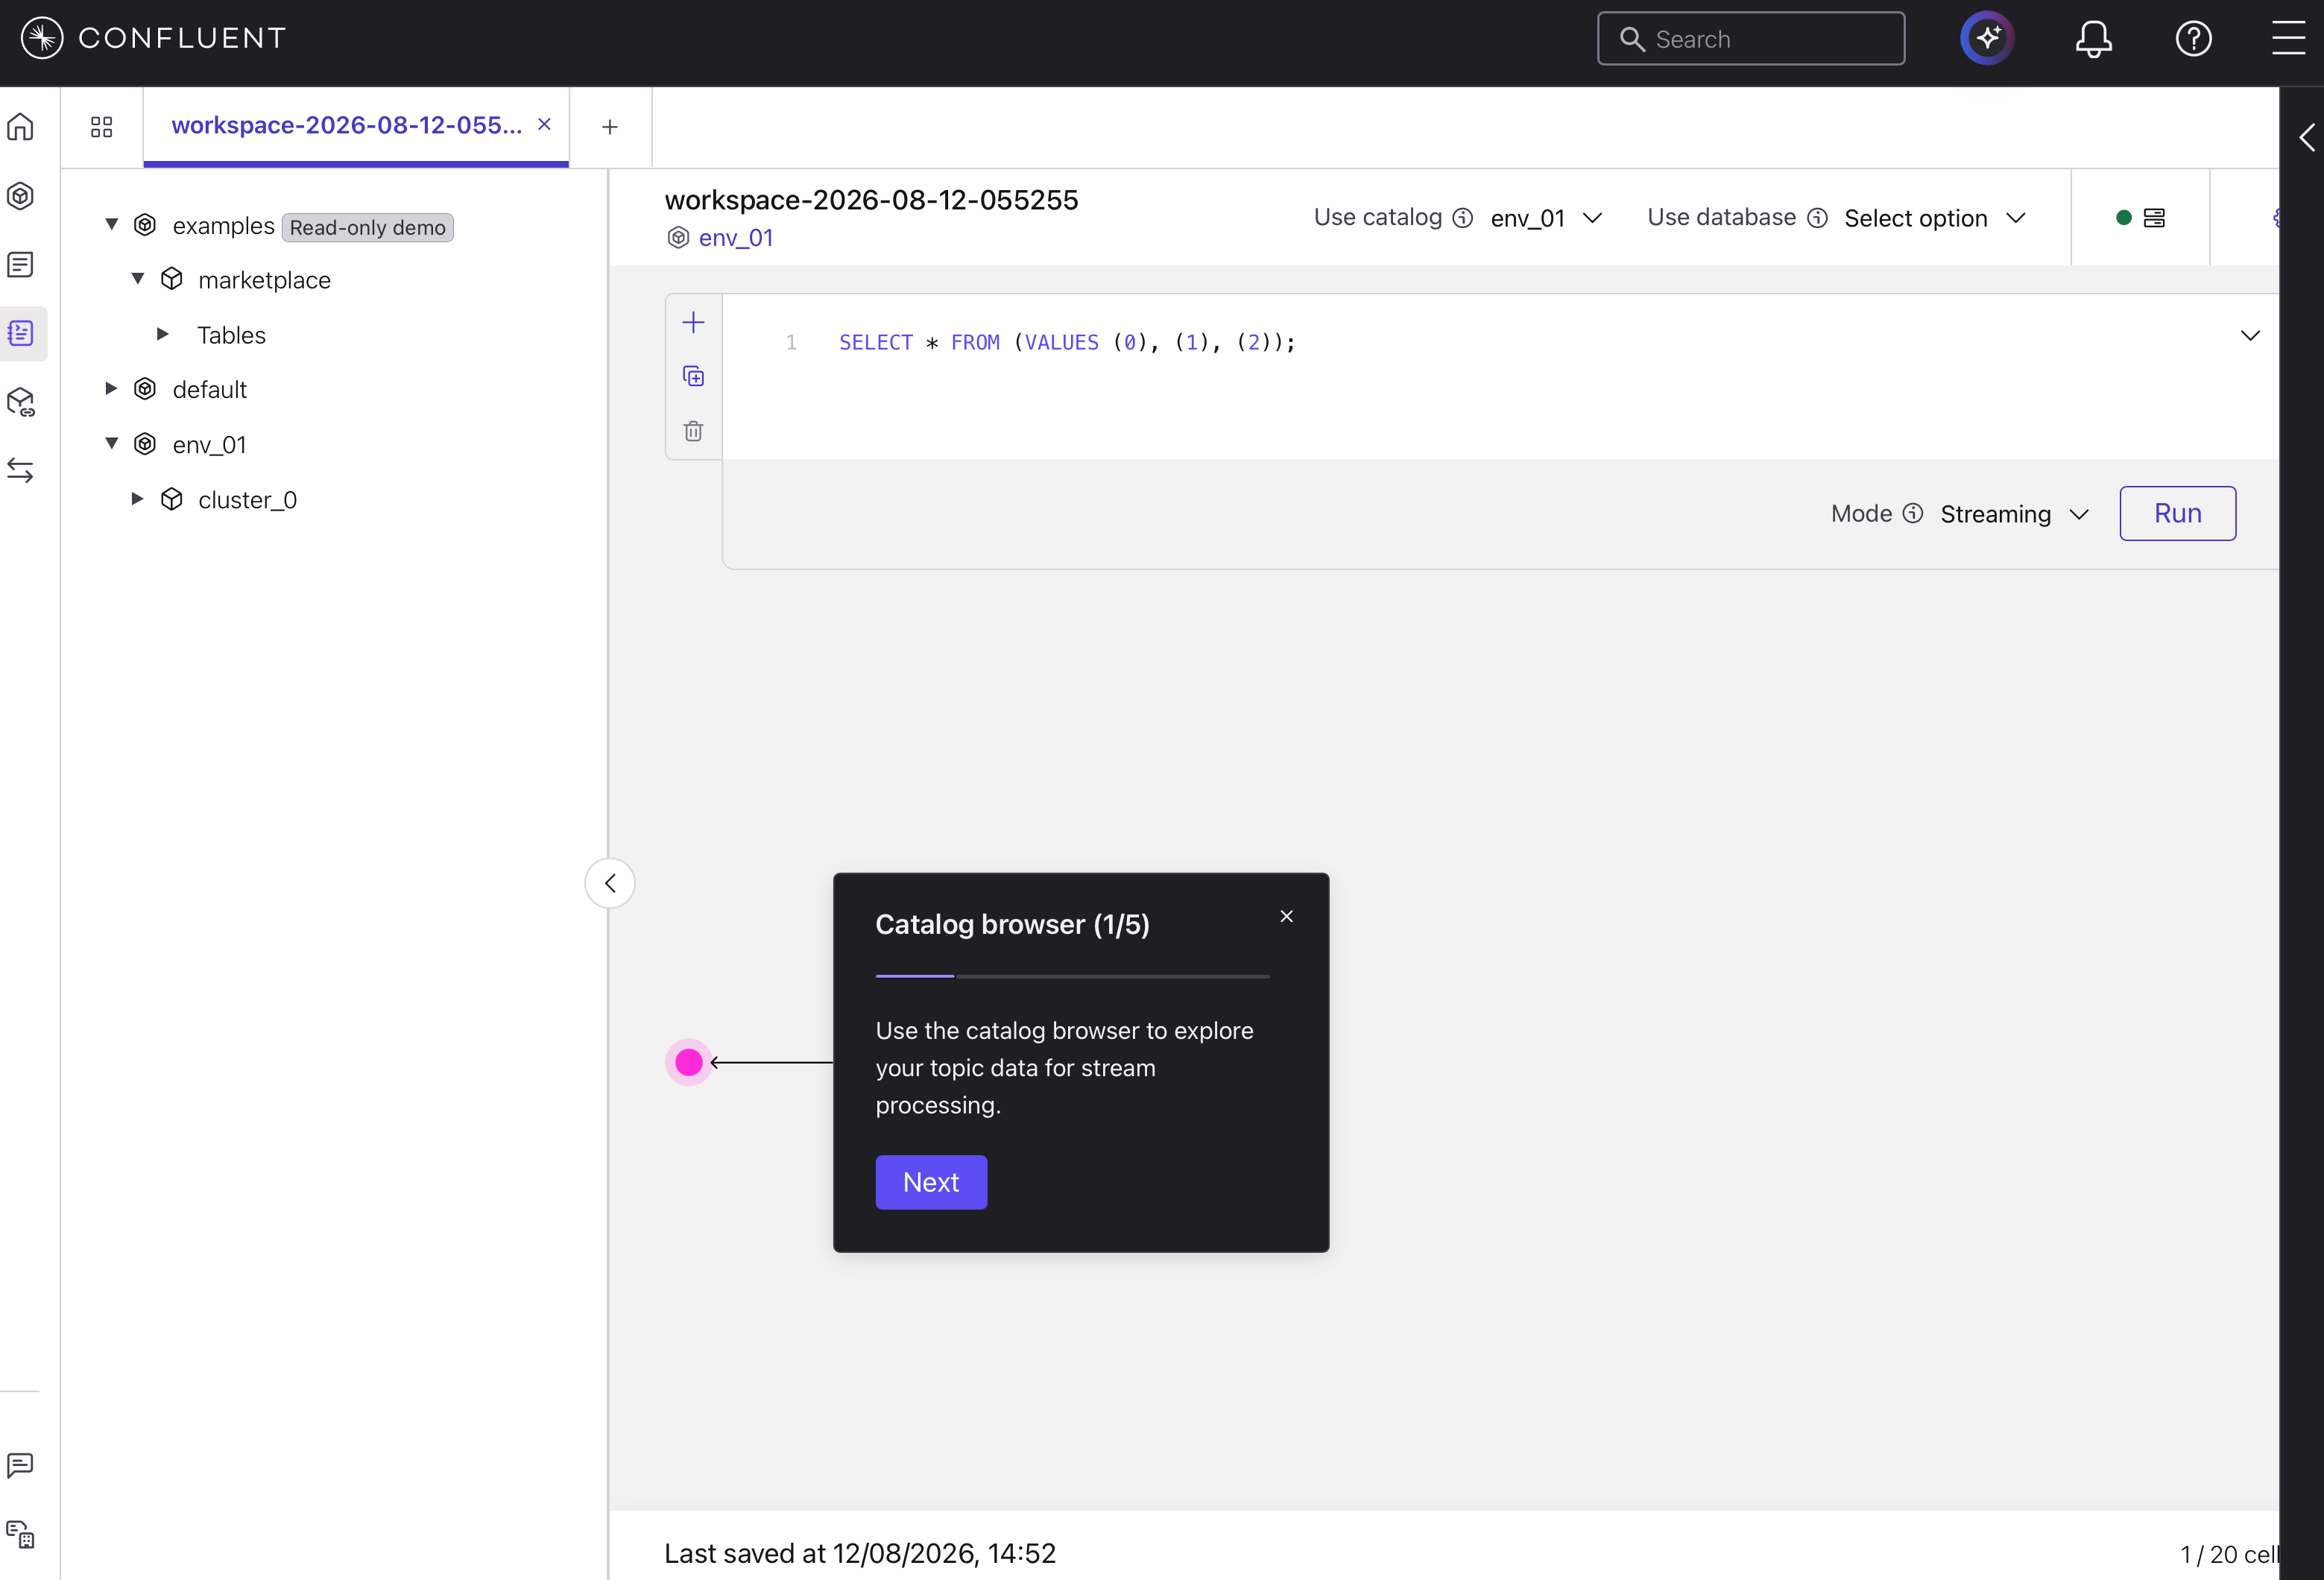
SQL ワークスペースには、既定でサンプルの SELECT 文が入力済みのエディター、Mode(Streaming)の切り替え、Run ボタンが用意されています。左側のカタログブラウザでは、Topic のデータをツリーで辿れます。Flink のカタログは環境、データベースはクラスターに対応しており、画面上部の Use catalog / Use database で既定の参照先を選択します。読み取り専用のデモカタログ(examples)も用意されているため、自身のデータを用意する前に動作を試すこともできます。
【重要】Freight クラスターへの書き込みには制約があります
Freight クラスターはトランザクションに対応していないため、Flink から Freight の Topic に書き込むジョブは、障害シナリオによっては重複レコードを生成する可能性があります。Exactly-Once Semantics(EOS)が必要な処理では、書き込み先のクラスタータイプにご注意ください。